
 Last ned
Norsk talegjenkjenning
Nasjonalbibliotekets norske versjon av Whisper. Hva den er, hvem som lagde den, hvor god den er på norsk, og hvordan du tar den i bruk.
Sist oppdatert
Hva er NB-Whisper?
NB-Whisper er en talegjenkjenningsmodell for norsk, laget av Nasjonalbibliotekets AI-lab. Den bygger på OpenAI Whisper, men er trent videre på rundt 66 000 timer norsk tale. Den største, NB-Whisper Large, har 2,2 % ordfeil på bokmål i NST-datasettet, mot 6,8 % for OpenAI Whisper Large-v3. Modellene er åpent tilgjengelige og kjører lokalt på egen maskin.
Whisper var allerede god på engelsk, men merkbart svakere på norsk: fagord, navn og dialekter ble ofte feil. Nasjonalbiblioteket sitter på en av verdens største samlinger av norsk tale med tekst, og brukte den til å lære modellen norsk skikkelig. Arbeidet er dokumentert i et eget forskningspaper (arXiv 2402.01917).
Hvor god er NB-Whisper på norsk?
NB-Whisper large gjør 2,2 % ordfeil på bokmål i NST-datasettet og 6,6 % i Fleurs, mot 6,8 % og 10,4 % for OpenAI Whisper Large-v3, ifølge NB-Whisper-paperet. Tallene gjelder NB-Whisper Large. Kviskr bruker en komprimert versjon av den som standard.
Tallene under er Word Error Rate (WER): andelen ord modellen skriver feil. Lavere er bedre. Begge radene er publiserte tall fra NB-Whisper-paperet.
| Måling | NB-Whisper Large | OpenAI Whisper Large-v3 | Kilde |
|---|---|---|---|
| NST-datasettet, bokmål (opplest) | 2,2 % | 6,8 % | NB-Whisper-paperet |
| Fleurs-datasettet, bokmål | 6,6 % | 10,4 % | Samme paper |
NST-datasettet, bokmål (opplest)
- NB-Whisper Large
- 2,2 %
- OpenAI Whisper Large-v3
- 6,8 %
- Kilde
- NB-Whisper-paperet
Fleurs-datasettet, bokmål
- NB-Whisper Large
- 6,6 %
- OpenAI Whisper Large-v3
- 10,4 %
- Kilde
- Samme paper
Datasett-tallene er målt på opplest og innspilt tale, ikke på diktering i arbeidshverdagen, så de er ingen garanti for hvert opptak. Mer om tallene og forbeholdene står på metodesiden. Tallene peker likevel tydelig samme vei: på norsk gjør NB-Whisper langt færre feil enn OpenAI Whisper.
Hvem står bak?
Nasjonalbibliotekets AI-lab utvikler språkmodeller for norsk basert på bibliotekets samlinger. NB-Whisper-modellene publiseres åpent på Hugging Face under NbAiLab, i størrelser fra tiny til large, med egne verbatim-varianter som skriver mer ordrett. Kviskr er ikke tilknyttet eller støttet av Nasjonalbiblioteket; vi bygger bare på modellene de har gjort tilgjengelige, og synes de fortjener mer oppmerksomhet.
Kviskr står på Nasjonalbibliotekets oversikt over løsninger som bygger på NB-Whisper, sammen med blant andre JoJo, Autotekst fra UiO og transkribere.no. Beskrivelsene der skriver leverandørene selv.
Apper som bruker NB-Whisper
Flere apper og tjenester bygger på NB-Whisper. Listen tar bare med det vi har funnet belegg for i leverandørenes egne beskrivelser eller på Nasjonalbibliotekets oversikt. Kontrollert 11.10.2026.
| App | Hva den gjør | Hvor talen behandles | Kilde |
|---|---|---|---|
| Kviskr | Mac-app: diktering i alle apper, møter og lydfiler. Har også Ekko, en versjon av NB-Whisper som Kviskr har trent videre | Lokalt på Macen | NBs oversikt |
| JoJo (VG) | Mac-app for å transkribere lyd- og videofiler. NB-Whisper kan lastes ned som ekstra modell | Lokalt på Macen | App Store |
| Sæga (Saega) | Mac-app for diktering på svensk og norsk. Norsk bruker NB-Whisper | Lokalt på Macen. AI-tekstfunksjonene går via skyen | saega.app |
| Sagascript | Åpen kildekode (MIT). Mac-app for diktering og filer, med NB-Whisper for norsk | Lokalt på Macen | GitHub |
| Dikta | Mac-app i menylinjen for diktering, med NB-Whisper Medium eller Large. Krever macOS 26 | Lokalt på Macen | GitHub |
| LocalWhisper | Åpen kildekode. Windows-app for diktering og lydfiler | Lokalt på PC-en | NBs oversikt |
| Autotekst (UiO) | Transkribering av opptak og teksting av video for UiO og ikke-kommersielle aktører | UiOs servere | NBs oversikt |
| transkribere.no | Nettjeneste for lydfiler, betaling per minutt | Servere i EU | NBs oversikt |
Kviskr
- Hva den gjør
- Mac-app: diktering i alle apper, møter og lydfiler. Har også Ekko, en versjon av NB-Whisper som Kviskr har trent videre
- Hvor talen behandles
- Lokalt på Macen
- Kilde
- NBs oversikt
JoJo (VG)
- Hva den gjør
- Mac-app for å transkribere lyd- og videofiler. NB-Whisper kan lastes ned som ekstra modell
- Hvor talen behandles
- Lokalt på Macen
- Kilde
- App Store
Sæga (Saega)
- Hva den gjør
- Mac-app for diktering på svensk og norsk. Norsk bruker NB-Whisper
- Hvor talen behandles
- Lokalt på Macen. AI-tekstfunksjonene går via skyen
- Kilde
- saega.app
Sagascript
- Hva den gjør
- Åpen kildekode (MIT). Mac-app for diktering og filer, med NB-Whisper for norsk
- Hvor talen behandles
- Lokalt på Macen
- Kilde
- GitHub
Dikta
- Hva den gjør
- Mac-app i menylinjen for diktering, med NB-Whisper Medium eller Large. Krever macOS 26
- Hvor talen behandles
- Lokalt på Macen
- Kilde
- GitHub
LocalWhisper
- Hva den gjør
- Åpen kildekode. Windows-app for diktering og lydfiler
- Hvor talen behandles
- Lokalt på PC-en
- Kilde
- NBs oversikt
Autotekst (UiO)
- Hva den gjør
- Transkribering av opptak og teksting av video for UiO og ikke-kommersielle aktører
- Hvor talen behandles
- UiOs servere
- Kilde
- NBs oversikt
transkribere.no
- Hva den gjør
- Nettjeneste for lydfiler, betaling per minutt
- Hvor talen behandles
- Servere i EU
- Kilde
- NBs oversikt
Vil du se hvordan Kviskr står mot andre dikteringsapper for Mac, også de som ikke bruker NB-Whisper, finner du det i sammenligningen av dikteringsapper.
Slik kjører du NB-Whisper selv
Er du utvikler, er den raskeste veien Python og transformers:
from transformers import pipeline

asr = pipeline(
    "automatic-speech-recognition",
    model="NbAiLab/nb-whisper-large",
)
print(asr(
    "opptak.mp3",
    chunk_length_s=28,
    generate_kwargs={"task": "transcribe", "language": "no", "num_beams": 5},
)["text"])
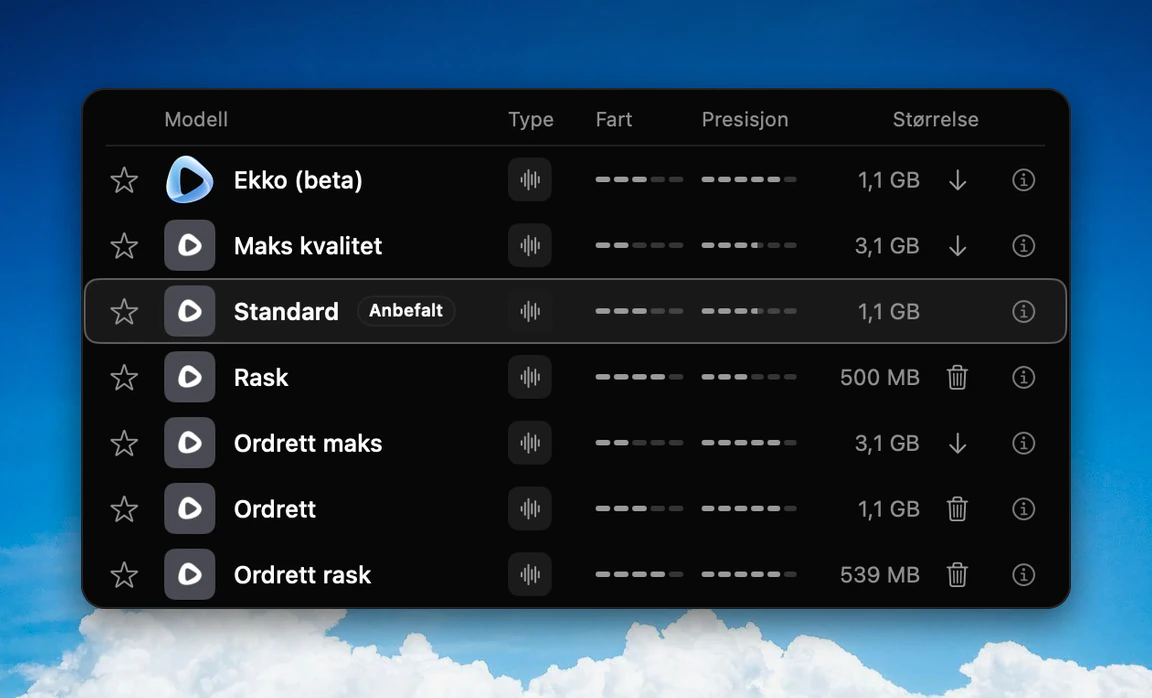
Nasjonalbiblioteket anbefaler selv chunk_length_s=28 og beam 5 for best treffsikkerhet i transformers. Vil du ha lav latens på Mac, er whisper.cpp veien: konverter modellen til GGML-format og kvantiser den (for eksempel q5_0), så kjører large-modellen komfortabelt på Apple silicon med Metal. Det er slik Kviskr kjører NB-Whisper-modellene. Standardmodellene er trent mot undertekstlignende tekst og kan omformulere lett, mens verbatim-variantene skriver mer ordrett. Til diktering anbefaler Kviskr likevel Standard, en komprimert NB-Whisper Large: i testene våre gjorde den færre feil ord enn verbatim-varianten Ordrett rask.
Den enkleste måten: en ferdig app
Vil du bare bruke NB-Whisper, ikke bygge med den, finnes det en ferdig vei: Kviskr er en Mac-app bygget rundt NB-Whisper. Hold en tast, snakk norsk, slipp, og teksten lander rett i feltet du jobber i, uansett app. Talemodellen følger med, og selve talegjenkjenningen kjører lokalt, og det er gratis i tidlig tilgang.
Gratis i tidlig tilgang. Ingen konto. Krever macOS 15.1 eller nyere og Apple silicon.
Spørsmål og svar
Les også: metoden bak tallene, vanlige spørsmål om Kviskr, NB-Whisper mot Apple-diktering, diktering på dialekt og lokal transkribering av lydfiler.